AI & Produktivitas
Membangun Pipeline Data Berkualitas untuk Proyek AI Skala Kecil hingga Menengah
Panduan langkah‑demi‑langkah untuk merancang, mengelola, dan memelihara alur data yang andal — mulai dari pengumpulan hingga pemantauan berkelanjutan — agar model AI memberikan...
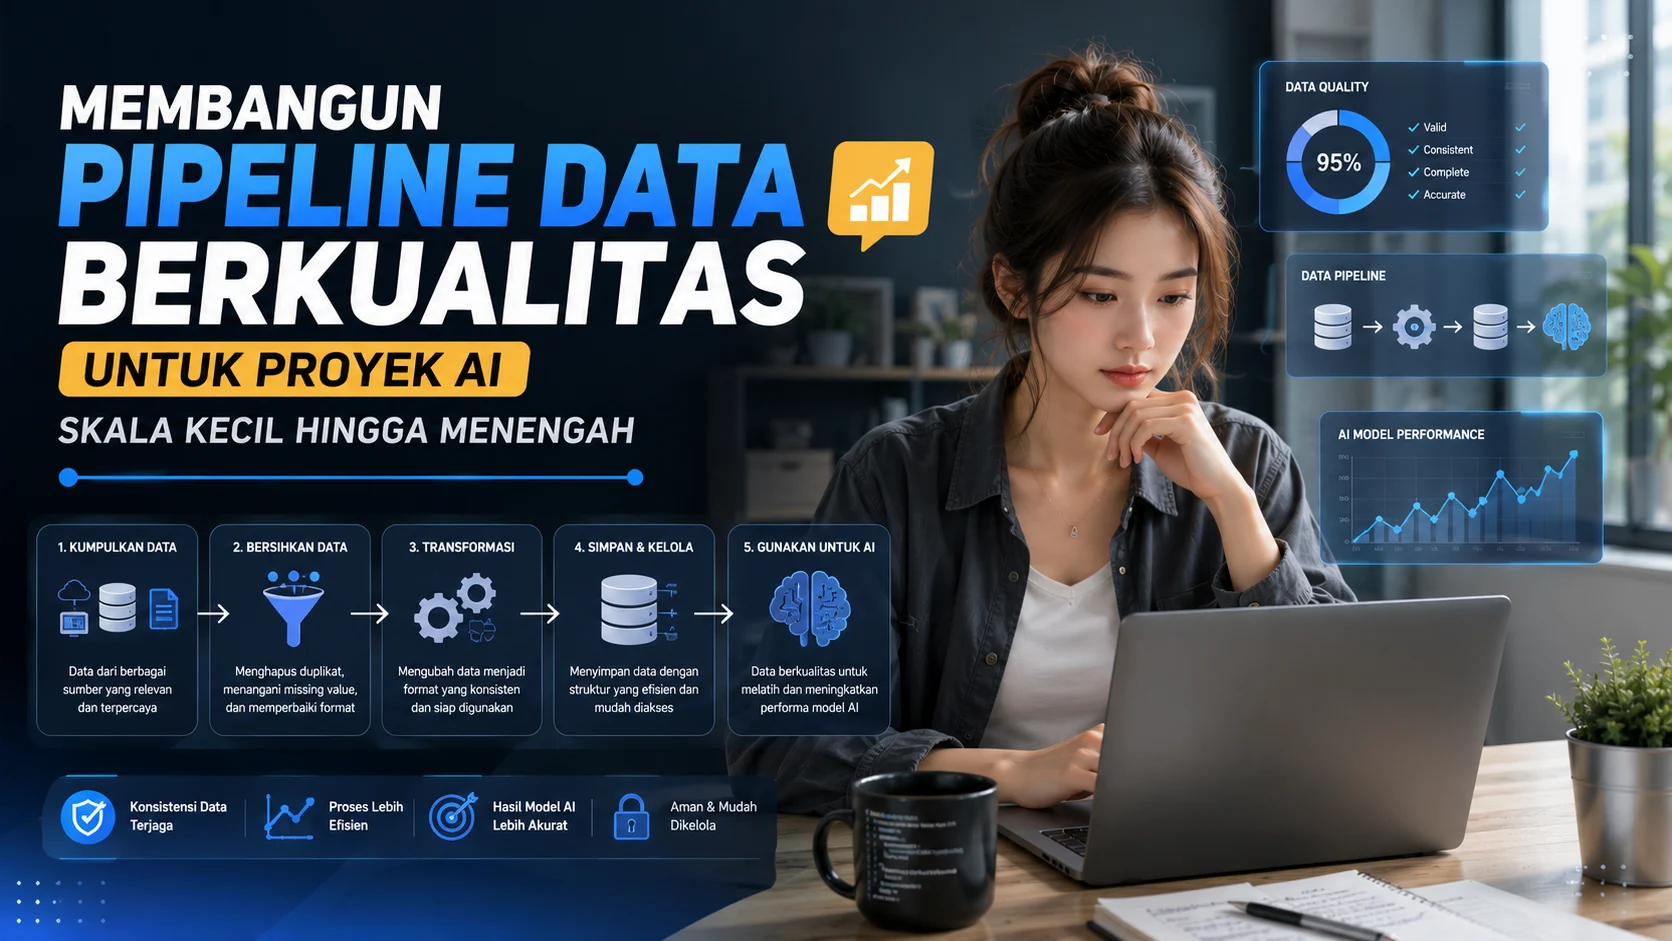
Pipeline data merupakan fondasi penting dalam proyek kecerdasan buatan. Model AI yang canggih sekalipun tidak dapat memberikan hasil optimal apabila data yang digunakan tidak konsisten, tidak lengkap, sulit dilacak, atau memiliki kualitas yang rendah.
Bagi proyek AI skala kecil hingga menengah, membangun pipeline tidak selalu berarti menggunakan arsitektur rumit dengan puluhan layanan. Sistem sederhana yang memiliki alur jelas, aturan validasi, dokumentasi, serta pemantauan yang baik sering kali sudah cukup untuk mendukung pengembangan model secara berkelanjutan.
Secara sederhana, pipeline data adalah rangkaian proses yang membawa data dari sumber awal menuju sistem penyimpanan, pembersihan, transformasi, pelabelan, validasi, hingga akhirnya digunakan oleh model AI.
Artikel ini membahas langkah praktis membangun pipeline tersebut. Jika pipeline sudah berjalan dan Anda ingin fokus pada tahap pengawasan, langsung menuju bagian [pemantauan kualitas data](#7-pantau-kualitas-data-dan-pipeline-secara-berkelanjutan).
1. Tentukan Tujuan Pipeline Sebelum Mengumpulkan Data
Kesalahan yang cukup umum dalam proyek AI adalah mengumpulkan sebanyak mungkin data tanpa menentukan kebutuhan sebenarnya.
Sebelum membuat pipeline, tentukan terlebih dahulu tujuan model dan bagaimana data akan digunakan.
Beberapa pertanyaan dasar yang dapat membantu antara lain:
- Masalah apa yang ingin diselesaikan?
- Data apa yang benar-benar dibutuhkan?
- Dari mana data diperoleh?
- Seberapa sering data berubah?
- Apakah data membutuhkan label?
- Bagaimana kualitas data akan diukur?
- Siapa yang bertanggung jawab terhadap data?
- Berapa lama data perlu disimpan?
Misalnya, proyek klasifikasi tiket layanan pelanggan memiliki kebutuhan berbeda dibandingkan sistem prediksi permintaan produk.
Sistem klasifikasi mungkin membutuhkan teks, kategori masalah, bahasa, dan label hasil penyelesaian. Sistem prediksi permintaan dapat membutuhkan data transaksi, periode waktu, stok, harga, atau variabel lain yang relevan.
Dengan menentukan tujuan sejak awal, tim dapat menghindari pengumpulan data yang tidak diperlukan.
Pipeline yang baik bukan pipeline yang memproses data sebanyak mungkin, melainkan pipeline yang menyediakan data relevan secara konsisten untuk kebutuhan sistem.
Pada tahap perencanaan, pendekatan manajemen risiko juga dapat dipertimbangkan. NIST AI Risk Management Framework menyediakan kerangka untuk membantu organisasi mempertimbangkan risiko dan keandalan sistem AI.
Sumber: NIST — AI Risk Management Framework | https://www.nist.gov/itl/ai-risk-management-framework
2. Bangun Proses Pengumpulan Data yang Konsisten
Setelah tujuan ditentukan, tahap berikutnya adalah mengidentifikasi sumber data.
Data dapat berasal dari berbagai tempat, seperti:
- Database internal.
- File CSV atau spreadsheet.
- API.
- Formulir pengguna.
- Log aplikasi.
- Sistem transaksi.
- Sensor.
- Dataset publik.
- Data yang dikumpulkan secara manual.
Untuk proyek kecil, penggunaan beberapa sumber sederhana sering kali sudah mencukupi. Kompleksitas sebaiknya ditambahkan ketika memang diperlukan.
Hal terpenting adalah memastikan proses pengumpulan dapat direproduksi.
Jika data hari ini dikumpulkan dengan metode tertentu, tim sebaiknya dapat memahami bagaimana proses yang sama dijalankan minggu atau bulan berikutnya.
Simpan informasi seperti waktu pengambilan data, sumber, versi skema, dan status proses apabila memungkinkan.
Pisahkan Data Mentah dari Data yang Sudah Diproses
Praktik yang berguna adalah menyimpan raw data secara terpisah dari data hasil transformasi.
Contoh struktur sederhana:
- `raw/` untuk data asli.
- `processed/` untuk data yang sudah dibersihkan.
- `validated/` untuk data yang lolos pemeriksaan.
- `training/` untuk dataset yang siap digunakan model.
Pemisahan tersebut membantu proses audit dan debugging.
Apabila hasil transformasi ternyata salah, tim masih memiliki data asli untuk menjalankan kembali pipeline tanpa harus mengumpulkan semuanya dari awal.
Namun, penyimpanan data mentah tetap harus mengikuti kebutuhan privasi, keamanan, izin penggunaan, dan kebijakan retensi organisasi.
3. Terapkan Validasi dan Pembersihan Data
Data yang berhasil dikumpulkan belum tentu siap digunakan.
Salah satu bagian penting pipeline adalah proses validasi.
Validasi membantu mendeteksi masalah sebelum data digunakan untuk pelatihan atau evaluasi model.
Beberapa pemeriksaan dasar dapat meliputi:
- Memastikan kolom wajib tersedia.
- Memeriksa tipe data.
- Mendeteksi nilai kosong.
- Mencari data duplikat.
- Memeriksa rentang nilai.
- Mengidentifikasi format yang tidak konsisten.
- Memeriksa perubahan struktur data.
Sebagai contoh, kolom usia seharusnya tidak tiba-tiba berisi alamat email. Kolom tanggal juga sebaiknya menggunakan format yang konsisten.
Aturan validasi tidak harus rumit pada tahap awal.
Untuk proyek kecil, beberapa pemeriksaan sederhana yang dijalankan otomatis setiap kali data masuk sudah dapat memberikan manfaat besar.
Jangan Menghapus Data Bermasalah Tanpa Catatan
Ketika pipeline menemukan data tidak valid, hindari langsung menghapusnya tanpa dokumentasi.
Pertimbangkan untuk memindahkan data tersebut ke area terpisah seperti quarantine.
Dengan demikian, tim dapat mengetahui:
- Data mana yang gagal.
- Mengapa data gagal.
- Kapan kegagalan terjadi.
- Sumber data bermasalah.
- Apakah aturan validasi perlu diperbaiki.
Pendekatan tersebut membuat pipeline lebih mudah diperiksa ketika terjadi perubahan kualitas data.
4. Kelola Pelabelan Data Secara Sistematis
Tidak semua proyek AI membutuhkan data berlabel. Namun, untuk supervised learning, kualitas label dapat memberikan pengaruh besar terhadap kualitas dataset.
Pelabelan dapat dilakukan secara manual, semiotomatis, atau menggunakan proses yang melibatkan sistem lain sebelum diverifikasi manusia.
Google Cloud menyediakan dokumentasi mengenai konsep pelabelan melalui Vertex AI Data Labeling Overview.
Sebelum proses labeling dimulai, buat pedoman yang jelas.
Misalnya, jika sebuah sistem mengklasifikasikan komentar menjadi positif, netral, dan negatif, tim harus menentukan bagaimana menangani komentar ambigu, sarkasme, atau teks yang mengandung beberapa sentimen sekaligus.
Tanpa panduan, dua orang dapat memberikan label berbeda untuk data yang sama.
Beberapa langkah yang dapat digunakan adalah:
- Buat definisi setiap label.
- Sertakan contoh positif dan negatif.
- Tentukan aturan untuk kasus ambigu.
- Lakukan pengujian pada sampel kecil.
- Bandingkan konsistensi antarpenilai.
- Revisi pedoman jika ditemukan banyak perbedaan.
- Dokumentasikan perubahan aturan.
Label yang konsisten sering kali lebih berguna daripada jumlah data besar dengan aturan pelabelan yang tidak jelas.
Sumber: Google Cloud Vertex AI Data Labeling Overview | https://cloud.google.com/vertex-ai/docs/data-labeling/overview
5. Buat Versi Dataset dan Catat Perubahannya
Dataset dapat berubah seiring waktu.
Data baru masuk, kesalahan diperbaiki, label direvisi, aturan validasi berubah, atau beberapa data mungkin harus dihapus.
Tanpa sistem versioning, tim dapat kesulitan menjawab pertanyaan sederhana seperti:
"Dataset mana yang digunakan untuk melatih model versi ini?"
Karena itu, buat identitas untuk setiap versi dataset.
Contohnya:
- `dataset-v1`
- `dataset-v1.1`
- `dataset-2026-08`
- `training-data-2026-08-24`
Selain nama versi, simpan metadata penting seperti:
- Waktu pembuatan.
- Sumber data.
- Jumlah record.
- Aturan transformasi.
- Versi skema.
- Perubahan dari versi sebelumnya.
- Hasil validasi.
- Model yang menggunakan dataset tersebut.
Dokumentasi sederhana seperti ini dapat mempercepat proses investigasi ketika performa model berubah.
Pisahkan Training, Validation, dan Test Data
Untuk proyek machine learning, dataset umumnya dibagi menjadi beberapa kelompok.
Training data digunakan untuk melatih model.
Validation data dapat digunakan dalam proses pemilihan atau penyetelan model.
Test data digunakan untuk mengevaluasi performa akhir pada data yang tidak digunakan dalam proses pelatihan.
Pembagian harus dilakukan secara hati-hati untuk mengurangi risiko data leakage.
Sebagai contoh, apabila data berasal dari pengguna yang sama dan memiliki banyak record yang sangat mirip, pembagian secara acak pada level record dapat menyebabkan informasi serupa muncul di training dan test set.
Akibatnya, hasil evaluasi dapat terlihat lebih baik daripada kemampuan model ketika menghadapi data baru.
6. Masukkan Keamanan dan Tata Kelola ke Dalam Pipeline
Pipeline data AI juga harus memperhatikan keamanan, privasi, dan tata kelola.
Tidak semua data yang tersedia otomatis layak digunakan.
Sebelum memasukkan dataset ke pipeline, periksa sumber, hak penggunaan, kebutuhan bisnis, dan potensi informasi sensitif di dalamnya.
Microsoft menjelaskan pendekatan terhadap pengembangan AI melalui Responsible AI, yang mencakup berbagai prinsip terkait pengembangan dan penggunaan sistem AI secara bertanggung jawab.
NIST melalui AI Risk Management Framework juga menyediakan pendekatan berbasis risiko yang dapat digunakan organisasi ketika mengembangkan dan menerapkan sistem AI.
Beberapa praktik yang dapat dipertimbangkan meliputi:
- Batasi akses berdasarkan kebutuhan.
- Hindari menyimpan data sensitif yang tidak diperlukan.
- Gunakan enkripsi ketika sesuai.
- Catat perubahan penting pada dataset.
- Tetapkan periode retensi data.
- Dokumentasikan sumber dataset.
- Periksa izin penggunaan data.
- Terapkan proses penghapusan data jika diperlukan.
Apabila pipeline menggunakan layanan atau model AI eksternal, periksa juga kebijakan penyedia layanan tersebut.
Sebagai contoh, penggunaan layanan OpenAI harus mengikuti Usage Policies OpenAI yang berlaku untuk layanan terkait.
Sumber: Microsoft Responsible AI | https://www.microsoft.com/en-us/ai/responsible-ai
Sumber: OpenAI Usage Policies | https://openai.com/policies/usage-policies
7. Pantau Kualitas Data dan Pipeline Secara Berkelanjutan
Pipeline tidak selesai ketika berhasil dijalankan pertama kali.
Data dunia nyata dapat berubah.
Format API berubah, kolom database ditambahkan, distribusi data bergeser, sumber data berhenti mengirim informasi, atau jumlah nilai kosong meningkat.
Karena itu, pipeline membutuhkan monitoring.
Beberapa metrik sederhana yang dapat dipantau adalah:
- Jumlah data yang masuk.
- Persentase nilai kosong.
- Jumlah data duplikat.
- Jumlah record yang gagal validasi.
- Waktu pemrosesan.
- Frekuensi kegagalan pipeline.
- Distribusi kategori.
- Perubahan nilai minimum dan maksimum.
- Persentase data yang berhasil diproses.
Misalnya, pipeline biasanya menerima 20.000 record setiap hari. Jika suatu hari hanya menerima 500 record, sistem sebaiknya memberikan peringatan sebelum dataset tersebut digunakan untuk proses berikutnya.
Begitu pula apabila sebuah kolom yang biasanya memiliki 1% nilai kosong tiba-tiba meningkat menjadi 40%.
Perubahan tersebut belum tentu berarti sistem rusak, tetapi layak diperiksa.
Hubungkan Monitoring Data dengan Performa Model
Pemantauan akan lebih bermanfaat apabila kualitas data dibandingkan dengan performa model.
Misalnya, akurasi model turun setelah distribusi kategori berubah secara signifikan. Tim kemudian dapat memeriksa apakah perubahan data tersebut memang mencerminkan kondisi baru atau terjadi karena kesalahan pipeline.
Catat hubungan antara:
- Versi dataset.
- Versi model.
- Konfigurasi pelatihan.
- Hasil evaluasi.
- Waktu deployment.
- Perubahan pipeline.
Dengan dokumentasi tersebut, proses investigasi menjadi jauh lebih sistematis.
OECD menyediakan sumber informasi mengenai pengembangan dan tata kelola AI melalui Artificial Intelligence OECD.
Sumber: OECD — Artificial Intelligence | https://www.oecd.org/en/topics/artificial-intelligence.html
Kesimpulan
Membangun pipeline data berkualitas untuk proyek AI tidak selalu membutuhkan infrastruktur yang sangat kompleks.
Untuk proyek kecil hingga menengah, fondasi yang kuat dapat dimulai dari proses sederhana: menentukan kebutuhan data, mengumpulkannya secara konsisten, melakukan validasi, mengelola label, membuat versi dataset, menerapkan kontrol keamanan, dan melakukan monitoring.
Hal yang paling penting adalah membuat setiap tahap dapat dilacak, diuji, dan direproduksi.
Ketika proyek berkembang, pipeline dapat ditingkatkan secara bertahap dengan otomatisasi, orkestrasi, observability, serta sistem tata kelola yang lebih matang.
Sebaliknya, membangun arsitektur terlalu kompleks sejak awal dapat meningkatkan biaya pemeliharaan tanpa memberikan manfaat yang sebanding.
Pipeline yang baik pada akhirnya bukan sekadar jalur pemindahan data. Pipeline merupakan sistem yang membantu memastikan model AI menerima data yang relevan dan konsisten sekaligus memberikan kemampuan kepada tim untuk mengetahui apa yang terjadi ketika kualitas data atau performa model berubah.
Sumber dan referensi
Ditinjau oleh: Manager
Disclosure: Artikel ini tidak mengandung promosi perjudian dan hanya menyajikan informasi edukatif.
Ingin diberi tahu saat ada artikel baru?
Tinggalkan nomor WhatsApp aktif. Kami kirim sesekali saja, hanya untuk artikel pilihan.
Nomor digunakan untuk menindaklanjuti permintaan ini. Lihat Kebijakan Privasi.